掌握一个系统最好的方式就是亲手实现一遍。这次确实实现了一遍,只是实现部分主要交给 AI,我负责出题、验收,以及写这篇复盘。
为什么要在显存之外再做一层
LLM 推理里的 prefix cache(radix cache)是个性价比极高的优化:如果两个请求共享前缀,第二个请求不需要重新 prefill 这段前缀,直接复用已经算好的 KV。system prompt、few-shot 示例、RAG 文档、agent 历史,这些都是天然反复出现的长度前缀。
问题在于显存容量有限。Mini-SGLang 的 L1 池按 token 数切页,请求量一大,早先的前缀很快会被 LRU 淘汰;一旦它再次出现,就只能从头 prefill 一遍。prefill 是纯计算密集型操作,重算已经算过的内容是很直接的浪费。
自然的想法是往下沉一层。CPU 内存比显存大一个数量级,本地 NVMe 又比内存大得多,把淘汰的 KV 页搬到那里,等再被命中时再搬回来。
于是有了三层:
- L1:显存里的物理池,attention kernel 直接读。
- L2:pinned 主机内存,走 PCIe 异步 DMA。
- L3:一个本地文件,固定 slot,走
pread/pwrite。
整套实现是 opt-in 的,只有开了 --enable-hicache 才生效。默认路径完全不变。现在的实现只支持 MHA,MLA 和 KV 量化不在范围内(MLA 的状态和后续计划见文末更新)。
整体结构
一次请求进来之后,匹配、决策、恢复大概是这样:
flowchart TD
    R[request] --> M[match shared HiRadixTree]
    M --> LEN["(l1_len, l2_len, l3_len)"]
    M --> C[online cost model]
    C --> D{"restore / recompute 决策"}
    D -->|L2 hit| H2D[H2D DMA]
    D -->|L3 hit| PRE[preadv]
    PRE --> H2D3[H2D DMA]
    D -->|recompute| PF[GPU prefill]
    H2D --> P[publish L1]
    H2D3 --> P
    PF --> P
    P --> DEC[decode]
关键点是这棵 radix 树只有一棵,三层共享同一套 token 拓扑。这个决定后面会展开。
数据结构:一棵树,三层 residency
节点
最核心的结构在 python/minisgl/kvcache/hi_radix_cache.py。每个节点同时记录三层的数据:
1
2
3
4
5
6
7
8
class HiRadixTreeNode:
    def __init__(self, key_fn, timestamp=None):
        self.children = {}
        self.parent = None
        self.key = torch.empty(0, dtype=torch.int32)
        self.values = dict.fromkeys(CacheTier)       # 每层各自的物理页索引
        self.ref_counts = dict.fromkeys(CacheTier, 0)
        self.timestamps = dict.fromkeys(CacheTier, initial_timestamp)
一个节点代表一段 token,values[tier] 是这段 token 在对应层里的物理页索引。三层是独立命中的:上层可能已经换出去了,L2 还在;或者 L2 被淘汰了,L3 还有。
如果每层各自维护一棵前缀树,仅让三套拓扑在插入、分裂、删除时保持一致,工作量就已经很大。所以这里反过来:拓扑只有一份,residency 挂在节点上。分裂节点时三层一起分裂,只有三层都没有数据、也没有存活子节点时才删除该节点。
一次匹配走一遍树
1
2
3
4
5
6
def match_prefixes(self, input_ids, *, include_storage):
    tiers = [CacheTier.GPU, CacheTier.HOST]
    if include_storage:
        tiers.append(CacheTier.STORAGE)
    lengths = dict.fromkeys(tiers, 0)
    ...
树上走一遍,同时累加每层自己的命中长度,返回一个 MatchResult,里面是三个 handle:cuda_handle、host_handle、storage_handle。上层拿到就可以比较三个长度决定用哪个。
页对齐是硬约束。匹配长度会 _align_down(value, page_size),因为传输的单位是整页,半个页无法传输。好处是后面所有的索引校验都能用「是不是整页、页号连不连续」来卡。
锁和引用计数
每个 tier 有独立的 refcount。一个 handle 在被用于 restore 或者正在被传输的时候要 lock,防止源页在传输途中被 LRU 淘汰。传输结束、元数据提交之后才 unlock。
这里有个容易写错的地方:L3 restore 的过程中会先把数据提升到 L2(promotion),再 L2→L1。这个过程既锁着 L3 的源 handle,又在 L2 上新建 handle,失败时释放顺序不能乱,否则要么泄漏要么把已经发布的页还回 free list。代码里 materialize_match 和 progress_materialization 在异常路径上处理的就是这件事。
淘汰
每层独立做 LRU 叶子淘汰。L1 淘汰只清 values[GPU],L2 淘汰只清 values[HOST],L3 淘汰只释放文件里的 slot。一个节点三层都空了才从树上摘掉。
物理布局:为什么三层长得不一样
L1 是 attention kernel 的泳道,布局是:
1
[K/V, layer, physical_page, token_in_page, local_kv_head, head_dim]
head 维度贴着 page 和 token,kernel 读取时的局部性最好。这个布局不能改。
L2 反过来了。如果沿用 L1 布局,同一个页在不同 layer 之间会隔着整个 pool,一页在物理上是不连续的,DMA 和文件 I/O 都会退化成大量碎片。所以 L2 是 page-major:
1
L2:  [page, K/V, layer, token_in_page, local_kv_head, head_dim]
一页从 K/V、所有 layer 到 token 全部连续。同时暴露一个 .buffer 属性,返回 permute 之后的 L1 顺序视图,上层读 KV 的代码不用改:
1
2
3
@property
def buffer(self):
    return self._page_buffer.permute(1, 2, 0, 3, 4, 5)
L3 是文件,逻辑上更简单。每页一个固定字节区间:
1
2
bytes_per_page = 2 * num_layers * page_size * local_kv_heads * head_dim * itemsize
offset(page)   = page * bytes_per_page
文件启动时 ftruncate 到 num_pages * bytes_per_page,之后所有偏移都是算出来的,没有分配。--hicache-storage-path 不指定就建个临时文件,退出删掉;指定了就在启动时 truncate,因为元数据是进程级的,旧文件直接不要。
传输:一次 gather,一次 DMA
这是整个优化里最影响性能的部分。以 D2H 为例,朴素做法是逐页、逐 layer 地拷贝,页数一多就会变成几千次小拷贝加一层 Python 循环,CPU 开销迅速失控。这里的做法是:
- 一个 Triton kernel 把所有选中页从 L1 的
[K/V, layer, page, ...]收拢成 packed 的 page-major 连续 buffer; - 一次异步 DMA 把整个 packed buffer 拷进 pinned 内存;
- 目标页在 L2 里如果本身连续,这一步可以省略;否则 CPU 侧做一次
index_copy_。
L2 的页分配器倾向于返回连续页,所以第 3 步经常直接走快路径:
1
2
3
4
5
if self._are_consecutive(host_pages):
    host_destination = host_pool.page_buffer[host_pages[0]:host_pages[0] + len(host_pages)]
    host_destination.copy_(packed_device, non_blocking=True)
else:
    workspace.host[:transfer_pages].copy_(packed_device, non_blocking=True)
H2D 是对称的:host 侧先 gather(连续则省),一次 DMA 上 GPU,再一个 Triton kernel scatter 到任意物理页。
workspace 复用
每次传输都分配 pinned buffer 会很慢,所以传输管理器维护一组 workspace,按页数 best-fit 复用。空闲的 workspace 只保留页数最大的一个,避免长前缀传输之后一直占着一大块 pinned 内存:
1
2
3
4
5
6
7
def _release_workspace(self, workspace):
    workspace.busy = False
    idle = [item for item in self._workspaces if not item.busy]
    if len(idle) > 1:
        keep = max(idle, key=lambda item: (item.pages, item.host is not None))
        self._workspaces = [item for item in self._workspaces
                            if item.busy or item is keep]
后来这里又改了一版。真正昂贵的是 pinned 分配:cudaHostAlloc 一个几十 MiB 的 buffer 要几十毫秒,而 GPU 侧 buffer 不到 1 ms。更不必要的是,pinned 的 page-major packing buffer 只在 host 侧物理碎片化时才会用到——连续页的情况下 DMA 直接落到 pinned L2 池上,这个 buffer 完全没有被访问。所以现在把它改成懒分配:连续路径不分配,碎片化路径才分配,分配过一次就保留复用。_release_workspace 也相应地在页数相同时优先留下已经带 pinned buffer 的那个。
1
2
3
4
5
6
7
8
9
10
host_is_consecutive = self._are_consecutive(host_pages)
workspace, created = self._acquire_workspace(
    transfer_pages, needs_host=not host_is_consecutive
)
...
if host_is_consecutive:
    host_destination = host_pool.page_buffer[host_pages[0]:host_pages[0] + len(host_pages)]
    host_destination.copy_(packed_device, non_blocking=True)
else:
    workspace.host[:transfer_pages].copy_(packed_device, non_blocking=True)
在 350 页、host 连续、pinned 分配器还没热起来的进程里,第一次 D2H 的 setup 能到几十毫秒量级;改成懒分配后这条路径不再碰 pinned,只剩下不到 1 ms 的 GPU buffer 开销。模型加载顺带把分配器预热了的进程里差别不大,但至少少占一份最多 L1 容量的 pinned 内存。
Triton kernel
gather 和 scatter 的索引是同一个映射,只是方向相反。把线性偏移拆成 (layer_kv, page, inner),然后用 page_ids 查表换页号:
1
2
3
4
5
6
7
8
9
10
11
12
13
@triton.jit
def hicache_gather_pages_kernel(source_ptr, page_ids_ptr, packed_ptr,
                                num_elements, num_layers, pool_pages, page_elements,
                                BLOCK_SIZE: tl.constexpr):
    offsets = tl.program_id(0) * BLOCK_SIZE + tl.arange(0, BLOCK_SIZE)
    mask = offsets < num_elements
    inner = offsets % page_elements
    logical_page = offsets // (page_elements * num_layers * 2)
    layer_kv = (offsets // page_elements) % (num_layers * 2)
    physical_page = tl.load(page_ids_ptr + logical_page, mask=mask, other=0).to(tl.int64)
    source_offsets = (layer_kv * pool_pages + physical_page) * page_elements + inner
    values = tl.load(source_ptr + source_offsets, mask=mask)
    tl.store(packed_ptr + offsets, values, mask=mask)
整个 buffer 被拍平成一维,每个 program 处理 BLOCK_SIZE=256 个元素,逻辑页号由整除得到,物理页号查一次表。因为只看一维偏移,gather 和 scatter 可以共用同一套 index 逻辑,写起来不容易错。
autotune
Triton 不一定比 PyTorch 快,尤其在页数少、几何不典型的时候。所以 auto 后端会在当前 KV 几何上分别测 Triton 和 torch 的 gather/scatter,各自选快的,允许混搭:
1
2
self.gather_backend = "triton" if gather_times["triton"] <= gather_times["torch"] * 1.05 else "torch"
self.scatter_backend = "triton" if scatter_times["triton"] <= scatter_times["torch"] * 1.02 else "torch"
两个阈值不一样,是因为 fused 实现省掉了 PyTorch 的临时 gather 分配,在压力下更稳定,所以 gather 给了 5% 的容错带,scatter 只给 2%。我们这台机器上选出来的是 gather=triton, scatter=torch。
编译挂了会自动退回 torch;如果显式指定了 --hicache-transfer-backend triton,失败就直接抛出来,不静默降级。
L3 的 I/O
L3 最怕的就是每页一次 syscall。这里做三件事。
固定 slot 的读写直接用 pinned tensor 的 memoryview,不经过 bytearray,也不序列化:
1
2
3
4
5
6
def _pwrite_all(self, data, offset):
    view = memoryview(data)
    written = 0
    while written < len(view):
        count = os.pwrite(self._fd, view[written:], offset + written)
        ...
读用 os.preadv,直接把数据读进最终 pinned tensor 的区间。
第二件是 extent 合并。源和目标都物理相邻的连续页才合并成一次 I/O,否则不合并,保证任意 remap 都正确:
1
2
3
4
5
6
7
8
9
10
@staticmethod
def _coalesce_mappings(source_pages, destination_pages):
    extents, first = [], 0
    for index in range(1, len(source_pages)):
        if (source_pages[index] != source_pages[index - 1] + 1
                or destination_pages[index] != destination_pages[index - 1] + 1):
            extents.append((first, index))
            first = index
    extents.append((first, len(source_pages)))
    return extents
长前缀在一次请求里通常是连续分配的,所以一个几千 token 的前缀往往就合并成几个 extent。我们的实测里 2000/3500 token 的 restore 都是 12 个 extent。
第三件是文件 I/O 交给有界线程池,不占主线程。
需要说明的是这里用的是可移植的 Python
preadv/pwrite,没有上io_uring、O_DIRECT,也没有 GPUDirect Storage。后面对性能的讨论基本都被这一点限制住了。
写穿状态机和所有权
新前缀落盘走的是写穿,路径是:
flowchart LR
    L1_PRIVATE --> D2H_PENDING --> L1_L2 --> H2S_PENDING --> L1_L2_L3
恢复反向:
flowchart LR
    L2 --> H2D_PENDING --> L1_L2
    L3 --> S2H_PENDING --> L2_L3 --> H2D_PENDING --> L1_L2_L3
每个 pending 操作会锁住源 handle,并且预留私有的目标页。只有在 CUDA event 或者 I/O future 成功之后,才提交元数据、把页的所有权交给树。失败时只回收还是私有的页,然后回退去重算。
代码里为此维护了六条不变量,我觉得最有价值的两条是:
- 树拥有的页、allocator 空闲页、传输私有页,三者必须不相交;
- 传输完成在元数据发布之前,元数据发布在
Req.cached_len更新之前。
第二条是正确性的命门。cached_len 一旦提前更新,上层就会去读还没搬完的页。
这些不变量在 HiRadixTree.check_integrity() 里会被主动验证:父指针、每层容量记账、refcount、页对齐、层内连续性、物理页是否重复。测试和基准每跑一段都会 check 一次,我们的 stress 里每次都是 passed。
在线代价模型:为什么不能无脑 restore
这是我觉得整个设计里最容易被忽略、但实际最影响体验的部分。
restore 不一定比重算快。前缀较短或存储较慢时,restore 的固定开销加上读带宽成本,可能还不如直接 prefill。如果策略是「有 L3 就 restore」,在没有 NVMe 的机器上就会稳定变慢。
所以默认策略是 cost。对 n 个可复用 token、每 token b 字节:
在 L2、L3、以及「只用 L1 命中」三个候选里取 benefit 最大的那个;如果最大的 benefit 也不为正,就不 restore,退回重算。
写穿是后台异步的,不占未来请求的关键路径,所以 admission 只按 restore 成本判断,不把备份成本算进去。这个选择是合理的:否则存储较慢时,系统会连备份都不愿执行。
模型一开始只有先验(recompute_us_per_token=50、host 12 GiB/s、storage 3 GiB/s,都在 EngineConfig 里)。真正的学习逻辑在 HiCacheCostModel。难点在于:只有一个尺寸的样本时,seconds = fixed + size * slope 的 fixed 和 slope 没法同时辨识。所以分两种情况:
如果最近窗口里的样本尺寸几乎没有差别,就保持带宽先验,只学 fixed 的正残差,用 EWMA:
1
2
def _ewma(previous, sample, alpha=0.2):
    return previous * (1 - alpha) + sample * alpha
一旦窗口里的尺寸有了明显方差(超过 max(1.0, maximum * 0.05)),就切到约束最小二乘,拟合出非负的截距和斜率。斜率为负或者截距为负都会退化回非负解:
1
2
3
4
5
6
7
fitted_slope = covariance / variance
if fitted_slope < 0:
    return max(0.0, mean_seconds), 0.0
fitted_fixed = mean_seconds - fitted_slope * mean_size
if fitted_fixed < 0:
    fitted_slope = sum(size * sec for size, sec in samples) / sum(size * size for size, _ in samples)
    fitted_fixed = 0.0
窗口大小 32。存储的读和写分开建模,因为写通常比读慢,模型不能让一次慢写把「未来 restore 很快」这个先验压死。
传输样本计的是 recurring time:enqueue、queue wait、kernel/DMA 或文件服务、CPU completion 都算,但一次性 workspace 分配不算,否则第一发长传输会把稳态带宽拉低。
把 restore 藏进 decode
restore 本质是 I/O 加 DMA,CPU 和 GPU 都可以执行其它工作。如果 restore 的时候整个 scheduler 停在那里等,GPU 就空转了。
Mini-SGLang 本来就是 overlap scheduling:overlap_loop 会在处理上一个 batch 结果的同时,准备下一个 batch。HiCache 的异步 restore 正好挂进这个循环。
具体是一个 PendingMaterialization。第一个 prefill 候选如果命中了低层,可以发起 S2H 或 H2D 之后先不阻塞,停进 pending 队列;scheduler 转去跑一个 runnable 的 decode batch;后面的迭代里 poll tick,推进 s2h -> h2d,最后发布 L1 并 admit。
1
2
3
4
5
6
7
8
9
10
def overlap_loop(self, last_data):
    ...
    allow_async_restore = self.hicache_prefetch and (
        last_data is not None or self.decode_manager.runnable
    )
    forward_input = self._schedule_next_batch(allow_async_restore=allow_async_restore)
    if (last_data is not None and last_data[0].batch.is_decode) or (
        forward_input is not None and forward_input.batch.is_decode
    ):
        self.cache_manager.mark_materializations_overlapped()
mark_materializations_overlapped 在确实有 decode 批次要跑的时候被调用,把这段时间记进 restore_overlapped_seconds。如果中途 request 被 abort 或者关闭,pending 状态会被 drain 或 cancel,不会泄露表项。--disable-hicache-prefetch 可以退回阻塞式 restore。
实现中遇到的问题
记录两个调试中遇到的问题。
一个是 H2D 的 stream 同步。device_page_ids 是在调用方当前 stream 上生成的,Triton scatter 直接消费它。如果传输用的私有 stream 不等一下调用方的 stream,就会读到还没初始化完的索引。很多小 workload 里 PyTorch 的 index_copy_ 恰好掩盖了这个 race,但换成 Triton 就会暴露出来。所以传输前必须 self.stream.wait_stream(torch.cuda.current_stream(...))。
另一个是 L3 promotion 的所有权。L3 restore 会先 S2H 到 L2 再 H2D 到 L1。S2H 完成、插入 L2 树之后,那些页的所有权就归树了。这时候如果再去分配 H2D 的目标页失败,清理逻辑绝不能把已经发布的 L2 页还回 free list。所以插入成功后要立刻把 pending.host_new_indices = None,把私有所有权清掉,再启动 H2D。
观测
hicache_status() 会输出容量、各层的 free/protected/evictable 页数、pending backup/materialization 计数、每方向的 autotune 结果和代价模型状态。metrics 包括:
- 三层的 hit token 数、recomputed token 数、eviction、promotion、fallback、policy skip;
- 四个方向(D2H/H2D/H2S/S2H)的字节、次数、稳态秒数和有效 GiB/s;
- L3 的 extent 数,用来把「碎片」和「带宽」分开看;
- enqueue、workspace setup、queue wait、service、端到端;
- restore 次数、端到端时间,以及和 decode 重叠的时间。
这些都是本地 introspection,不暴露成 HTTP 端点。
实测
环境与测试设置
结论和硬件关系很大,所以我在两组机器上各跑了一遍,放在一起对比:
| A 组 | B 组 | |
|---|---|---|
| GPU | RTX PRO 6000 Blackwell Server Edition(SM120) | RTX 5070(12 GB) |
| 模型 | Qwen3-8B,BF16 | Qwen3-4B,BF16 |
| KV 几何 | 36 层 / 8 KV heads / head_dim 128 | 与 A 组相同 |
| 每 token KV | 2 * 36 * 8 * 128 * 2 = 147456 字节 |
与 A 组相同 |
| 后端 / page size | FlashInfer / 1 | 与 A 组相同 |
| L3 | 根文件系统上的文件 | 根文件系统上的文件(ext4 虚拟盘) |
| 存储 | 无 NVMe;根分区 LVM,O_DIRECT 写 267 MB/s、读 980 MB/s;另一块 18T 机械盘 |
无 NVMe |
两组模型的 KV 几何完全相同,每页、每 token 的字节数一样,所以可以直接比。
延迟测试用 benchmark/offline/bench_hicache.py:造两个不同的假前缀交替请求,强制把上一个前缀淘汰出显存,再强制指定 restore tier。两组都取 8 次迭代的中位数、前 2 轮 warmup,--policy always 强制 tier,每个 prefix 单独配 --num-pages 保证两条前缀超出 L1 容量;B 组每个点跑两遍取平均。所有 run 的输出都能和重算逐 token 对齐,check_integrity() 全过。L2 容量是 L1 的 2 倍,L3 是 1 倍内存 + 2 倍文件(脚本默认值)。
吞吐测试用 benchmark/offline/bench_hicache_stress.py:8 个 350 token 前缀轮转,80 个请求,batch size 1,默认 cost 策略。
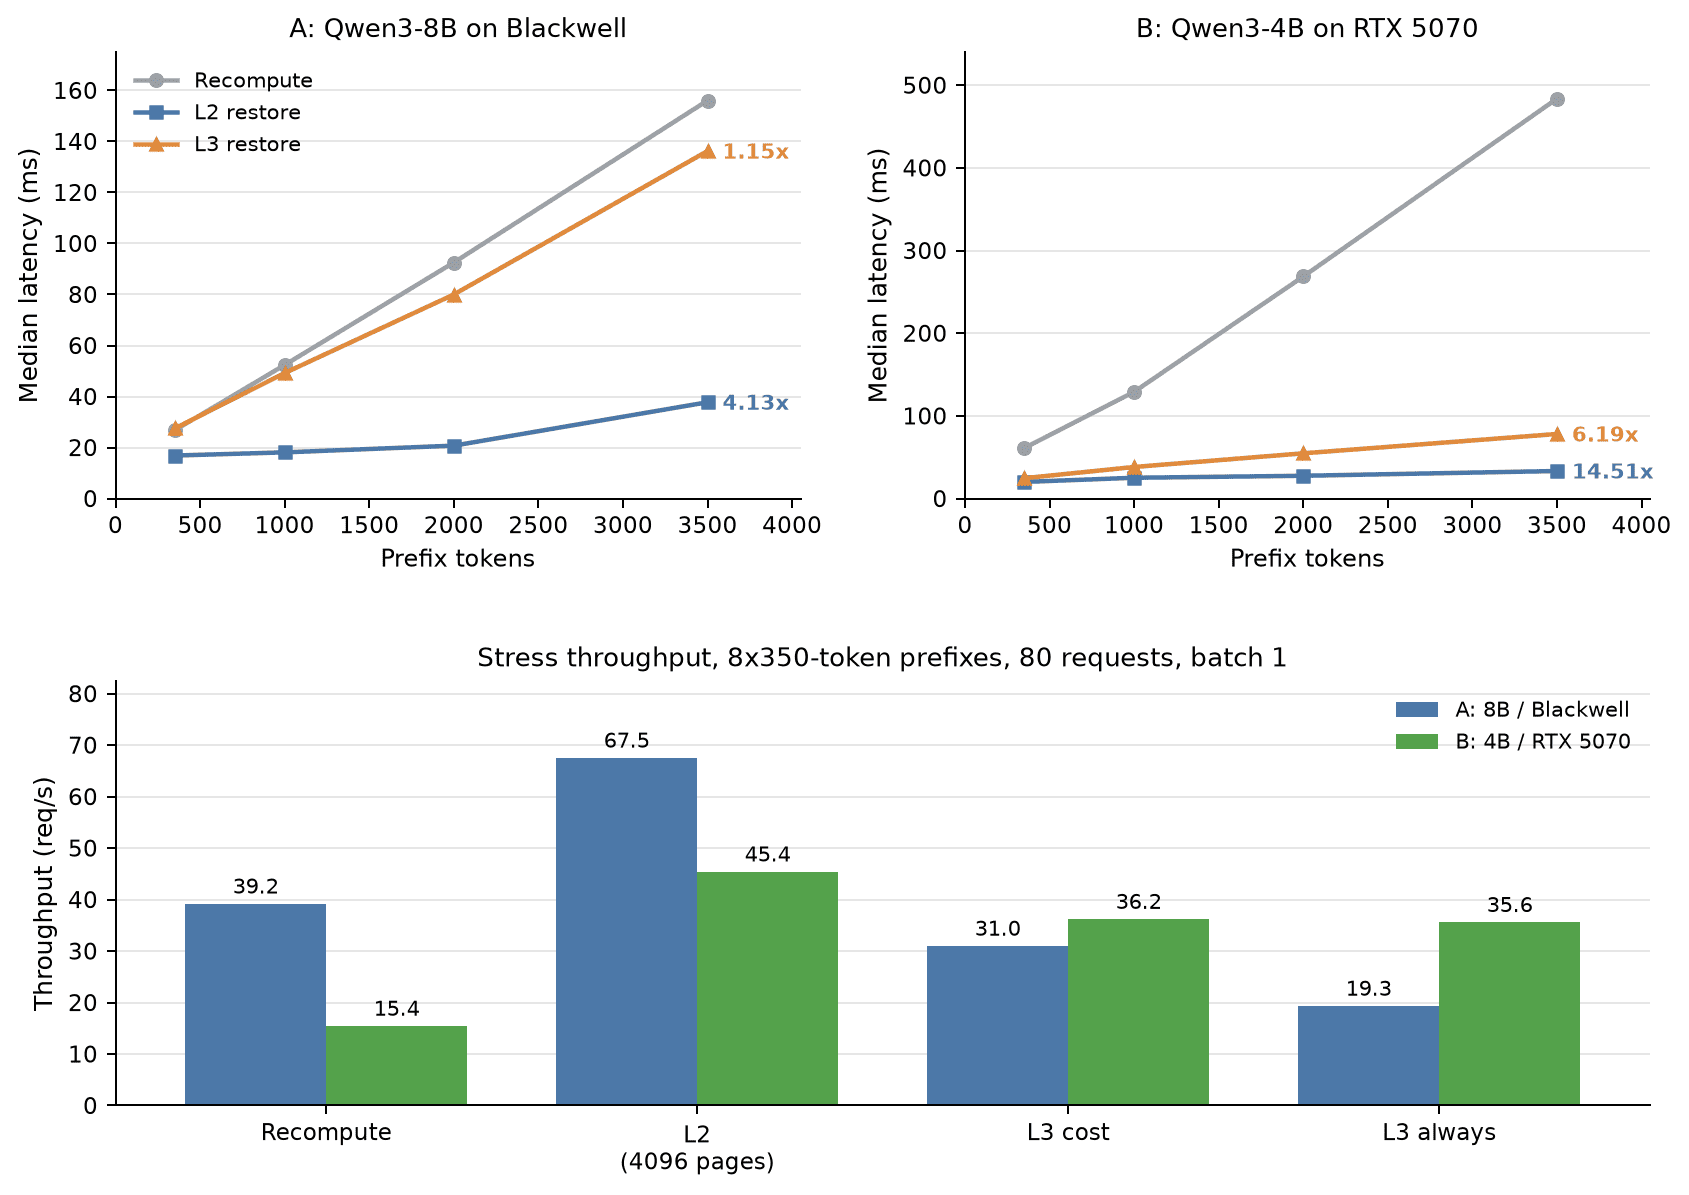
延迟
| prefix | A 重算 | A L2 | A L3 | B 重算 | B L2 | B L3 |
|---|---|---|---|---|---|---|
| 350 | 26.76 ms | 16.86 ms | 27.47 ms | 61.04 ms | 20.12 ms | 24.62 ms |
| 1000 | 52.38 ms | 18.11 ms | 49.20 ms | 129.09 ms | 25.16 ms | 38.19 ms |
| 2000 | 92.53 ms | 20.74 ms | 79.99 ms | 268.61 ms | 27.56 ms | 54.72 ms |
| 3500 | 156.03 ms | 37.76 ms | 136.23 ms | 483.74 ms | 33.33 ms | 78.11 ms |
对应的加速比:
| prefix | A L2 | A L3 | B L2 | B L3 |
|---|---|---|---|---|
| 350 | 1.59x | 0.97x | 3.03x | 2.48x |
| 1000 | 2.89x | 1.06x | 5.13x | 3.38x |
| 2000 | 4.46x | 1.16x | 9.75x | 4.91x |
| 3500 | 4.13x | 1.15x | 14.51x | 6.19x |
两组的重算都基本线性于 token,但斜率差很多:A 组 3500 token 约 45 us/token,B 组约 138 us/token。L2 restore 两组都只多一次 H2D(30 GiB/s 上下),所以都是一条缓慢上升的线;B 组因为重算更贵,加速比从 3.03x 一路涨到 14.51x,而 A 组到 3500 token 时 L2 restore 本身从 20.74 ms 跳到 37.76 ms,倍数反而从 4.46x 回落到 4.13x。
L3 两组的形状差别最大。A 组 350 token 时还是负的,1000 附近刚超过 1,之后停在 1.15 左右不再上升;B 组一路涨到 6.19x,没有平台期。原因放到本节最后展开。
吞吐
| 环境 | 配置 | 吞吐 | 有效延迟 | P50 | P99 |
|---|---|---|---|---|---|
| A:8B / Blackwell | 重算 | 39.18 req/s | 25.53 ms | 25.41 | 26.70 |
| A | L2(4096 host pages) | 67.53 req/s | 14.81 ms | 14.77 | 15.28 |
| A | L3 cost(512 host + 4096 storage) | 30.99 req/s | 32.27 ms | 31.57 | 44.72 |
| A | L3 always(根分区) | 19.33 req/s | 51.72 ms | — | 66.74 |
| B:4B / RTX 5070 | 重算 | 15.44 req/s | 64.76 ms | 63.81 | 69.53 |
| B | L2(4096 host pages) | 45.41 req/s | 22.02 ms | 21.18 | 29.99 |
| B | L3 cost(512 host + 4096 storage) | 36.20 req/s | 27.62 ms | 26.96 | 36.59 |
| B | L3 always | 35.59 req/s | 28.10 ms | 27.36 | 33.80 |
L2 两组都明显受益:A 组 1.72x,B 组 2.94x。
L3 的差别正好体现了 cost 策略的作用。A 组默认 cost 下,80 个请求里 L3 只命中了 698 个 token,剩下 32902 个全部退回重算,吞吐 30.99,反而低于纯重算的 39.18——因为多付出了写穿的带宽和 CPU;换成 always 强制 restore,根分区上直接降到 19.33 req/s。B 组则相反,cost 命中 27920 个 token、只剩下 80 个边界 token 重算,吞吐 36.20,是纯重算 15.44 的 2.34x,而且和 always(35.59)几乎一样。同一份策略在两组上给出了相反的选择,两次都判断对了。
为什么两组的 L3 收益差这么多
把每 token 的成本逐项列出,两组用同一个模型算。
L3 restore 每 token 要读 0.000137 GiB。A 组实测 S2H 4.3 GiB/s、H2D 30 GiB/s:
\[t_{L3}(A) \approx \frac{0.000137}{4.3} + \frac{0.000137}{30} \approx 31.9\,\mu s + 4.6\,\mu s \approx 36.5\,\mu s\]而 A 组 3500 token 的重算是 45 us/token,两者只差 1.2 倍;减掉 restore 的固定开销,剩下的就是 1.15x。
B 组存储快得多,S2H 约 11 GiB/s:
\[t_{L3}(B) \approx \frac{0.000137}{11} + \frac{0.000137}{30} \approx 12.5\,\mu s + 4.6\,\mu s \approx 17.1\,\mu s\]B 组重算是 138 us/token(483.74 ms / 3500),比值 8.1x,实测 6.19x,差的部分被固定开销吃掉了。
所以两组的差距来自两个方向叠加:B 组重算贵了 3 倍,存储又快 2.5 倍,一起把「存储带宽 ÷ 重算速度」这个比值拉开了一个数量级。A 组之所以有平台期,就是因为它的重算成本(45 us/token)和 L3 每 token 成本(36.5 us)在同一量级,L2 命中之后再往上提的空间很有限。L2 两组都只多一次 H2D(每 token 约 4.6 us),所以都是长前缀收益更大,区别只是 B 组的重算更贵,放大得更明显。
这也是设计文档里那个 2.22x 的来源:RTX 5070 + 本地 NVMe 的组合重算慢(每 token 成本高)、存储快(12.4 GiB/s),和 B 组是同一个方向;而 A 组用 Blackwell 的算力把这个收益窗口压窄了。
和 SGLang HiCache 的关系
Mini-SGLang 本来就是 SGLang 的精简版,HiCache 这个想法也是从 SGLang 借的,设计文档里把 SGLang HiCache 列在 prior art。但两边在取舍上差别不小,这一节逐项说明。
先说定位。SGLang HiCache 面向生产部署:L3 是集群里共享的分布式存储,Mooncake、DeepSeek 3FS、NIXL、AIBrix 都能接,L1/L2 每个实例私有,L3 跨实例共享,基本就是 CPU 三级缓存那套结构。官方 blog 报的数字也是这个量级:Qwen3-Coder-480B 接 3FS,平均 TTFT 降 56%、吞吐翻倍、命中率从 40% 涨到 80%;Mooncake 配 DeepSeek-R1-671B 的 PD 分离部署,命中相比全量重算 TTFT 降 84%;整体最高 6x 吞吐。这些都是 480B/671B 加分布式存储加集群的场景。
Mini-SGLang 这边 L3 就是一个进程级的本地文件,没有 RDMA、没有跨实例共享、没有崩溃持久化。所以两边的性能数字没法直接比,能比的是设计选择。
| 维度 | SGLang HiCache | Mini-SGLang HiCache |
|---|---|---|
| L3 形态 | 分布式存储,跨实例共享;本地文件只是 demo | 本地文件,进程级,退出即删 |
| L3 元数据 | 不存本地,访问时向后端实时查询是否存在、在哪 | 存在共享 HiRadixTree 节点上,带 per-tier refcount 和 LRU |
| 主机内存布局 | 可选 layer_first / page_first / page_first_direct |
固定 page-major(等价 page_first),另给 L1 兼容视图 |
| L2→L1 传输 | cudaMemcpyAsync + GPU-assisted I/O kernel;按 layer 和 prefill 计算重叠 |
fused Triton gather/scatter + 单次 DMA;整批一次拷完,不做 layer 级重叠 |
| L3 传输 | 零拷贝,把地址和长度直接交给后端 | preadv/pwrite + extent 合并,线程池 |
| restore 决策 | 预取阈值(默认 256 token)+ 策略 best_effort/wait_complete/timeout |
在线代价模型,逐请求评估 recompute 和 restore 的成本 |
| 写回策略 | write_through / write_through_selective(按 hit count)/ write_back(淘汰时) |
统一写穿,是否备份由代价模型判断 |
| 多 rank 一致性 | all_reduce(min) 同步各 rank 的 L3 命中长度和预取状态 |
靠确定性调度,L3 文件带 .rankN 后缀 |
| 覆盖范围 | MHA + MLA,PD 分离,多种远端后端 | 仅 MHA,单机 |
几个差异值得单独说。
元数据放哪。 SGLang 不缓存 L3 元数据。因为 L3 是共享的,别的实例随时可能写入或淘汰,本地存了也会失效,所以每次访问都向后端实时查询。Mini 的 L3 是本进程独占的文件,元数据在本地就是权威的,所以直接挂在树的节点上,三层共享一棵树。代价是 mini 天然做不了跨实例共享——树只知道自己写过什么。反过来说,如果以后要给 mini 接远端 L3,这棵「全知」的树反而是最先需要重构的部分。
怎么决定 restore。 SGLang 用的是一组可调的固定规则:L3 命中不足 256 token 不预取,超时按 token 数线性算,写回按 hit count 阈值,load_back 还有一个最小长度。这些规则行为可预测、能对外暴露参数,代价是每个都要按硬件和负载手调,调不好就退化成「要么根本不预取,要么让请求空等」。Mini 换成在线代价模型,把 recompute 和每一层 transfer 的 fixed/slope 都测出来,逐请求计算 benefit。前面实测里,同一份 cost 策略在 A 组(算力强、存储慢)主动避开 L3,在 B 组(算力弱、存储相对快)又选择 L3,就是这个差别的直接体现:固定策略很难同时覆盖这两种情况。当然代价是模型可能估计不准,而且多了一份需要维护的状态。
传输路径。 SGLang 在 H2D 上做 layer 级重叠,加载第 N+1 层 KV 的同时算第 N 层,把传输藏进 prefill 计算里,另外还写了 GPU-assisted I/O kernel,官方说比 cudaMemcpyAsync 快最多 3x。Mini 没走这条路,而是把一页的所有 layer 打包成一个连续 buffer,一次 DMA 拉过去,再用一个 Triton kernel 在 GPU 上 scatter 到任意物理页。两边都在减少拷贝次数,但 SGLang 更像是在做计算-传输流水线,mini 更像是在把传输本身压成一次大操作。前缀长、页大的时候一次大 DMA 不差,但 mini 没有 layer 重叠,省下的 H2D 延迟不会被 prefill 计算盖住,这是它比 SGLang 弱的地方。
规模。 SGLang 是几万行的生产系统,仅 hiradix_cache.py 就 1500 行,memory_pool_host.py 2600 行,还有大量后端适配;mini 的传输层加树加调度一共三千行左右。mini 的价值不是性能对标,而是把「三层共享一棵 radix 树 + 在线代价模型 + 写穿状态机」用能读懂的量级写清楚。
所以真要在生产里接远端存储、跨实例共享,SGLang 是唯一选择。mini 这套如果有什么值得往回反馈的,我认为是那个在线代价模型:SGLang 目前的一大类问题(预取阈值、超时、写回阈值怎么调)本质上都是在估计 restore 是否划算,而这恰好是可以在线测量出来的量。
结论
L2 的收益是稳定的。长前缀下 4 倍以上,短前缀也有 1.6 倍,不需要调参,默认就开。
L3 完全取决于硬件,也取决于模型大小。8B + Blackwell 上它基本没有收益(3500 token 才 1.15x),同一份代码换到 4B + RTX 5070 上,3500 token 能到 6.19x,而且 prefix 越长收益越大,cost 策略两次都判断正确。原因就是前面那个比值:重算越贵、存储相对越快,L3 的收益越大。算力强、存储慢的时候,cost 策略会避开这类情况,但写穿本身仍要付出带宽和 CPU 代价。
实现上我认为最有价值的是两件事:
一是三层共用一棵 radix 树。避免了多套索引在插入、分裂、淘汰时对齐的复杂度,代价是每个节点多存几个 dict。
二是在线代价模型。它让系统在参数没有针对硬件调好的情况下也不至于明显变慢,而不是默认 restore 一定更快。这个设计在 L3 场景尤其重要,因为 restore 和 recompute 的胜负本来就依赖具体硬件,写死的策略一定会在部分机器上判断错误。
后面能做的:L3 换成 io_uring / O_DIRECT 或者 GPUDirect Storage,写穿批量化,restore 和 decode 的 overlap 再激进一些。不过在这些之前,先给机器加装 NVMe 更实际。
更新(09-18):merge 进了 mini-deepseek
这个分支已经 merge 进 mini-deepseek(和 MLA + MoE 那条线汇合,冲突 8 个文件,基本都是「两边各自新增」型:CacheManager 现在同时接受淘汰策略参数和全套 hicache 参数,check_integrity 保留了更强的一版并补上了重复物理索引检查)。
MHA-only 的限制还在:传输层的 gather/scatter 和 L2 布局都硬编码了 [2, layer, page, ...] 的 MHA 转置,MLA 的 latent 是分开的 ckv/kpe 两个 buffer,需要一条新的 page-major 传输路径。现在启用 hicache 时 MLA 池会被明确拒绝,而不是静默错——这在 mini-sglang 的设计文档里 tracked 为 mini-hicache-mla。好消息是方向是对口的:MLA 每 token 只有 576 个元素、且天然是两个独立 buffer,做 page-major 打包比 MHA 还简单,那次 merge 只是让两条线先共存,把地基打好。
复现
完整实现在 nothiny/mini-sglang 的 mini-hicache 分支:
https://github.com/nothiny/mini-sglang/tree/mini-hicache
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 环境
uv venv --python=3.12 && source .venv/bin/activate
uv pip install -e .

# 强制 tier 的延迟对比(重算把 tier 换成 none,L2 换成 l2)
# 两组用同一组命令,只换 --model;A 组是 Qwen3-8B,B 组是 Qwen3-4B
# 每个 prefix 单独配 --num-pages(保证两条前缀超出 L1 容量):
#   B 组 350 / 1000 / 2000 / 3500 对应 512 / 1536 / 3072 / 4096
CUDA_VISIBLE_DEVICES=6 python benchmark/offline/bench_hicache.py \
    --model /path/to/Qwen3-8B --attention-backend fi --tier l3 \
    --num-pages 4096 --prefix-tokens 3500 --policy always \
    --iterations 8 --warmup-alternations 2

# 吞吐对比(tier 取 none / l2 / l3)
CUDA_VISIBLE_DEVICES=6 python benchmark/offline/bench_hicache_stress.py \
    --model /path/to/Qwen3-8B --attention-backend fi --tier l3 \
    --num-pages 512 --prefix-tokens 350 --num-prefixes 8 \
    --requests 80 --batch-size 1 --max-tokens 1 \
    --host-ratio 1 --storage-ratio 8 --policy cost
数据是共享机器上跑的,别的卡当时还有训练任务,绝对数字仅供参考,趋势比数值可靠。
评论